Appearance
MongoDB 与 Elasticsearch
来源:用户提供的《golang 云原生面试题》PDF。下列为原文完整导入,按主题重排;页码为 PDF 物理页码。技术观点与示例保留原件语境,勘误请结合 校正说明 阅读。
ObjectID 有哪些部分组成
PDF 出处:第 104–104 页 · 原卷分组:MongoDB 面试题 · 源标题
p104-h03。
一共有四部分组成:时间戳、客户端 ID、客户进程 ID、三个字节的增量计数器
当我试图更新一个正在被迁移的块(chunk)上的文档时会发生什么
PDF 出处:第 104–104 页 · 原卷分组:MongoDB 面试题 · 源标题
p104-h04。
更新操作会立即发生在旧的分片(shard)上,然后更改才会在所有权转移 (ownership transfers)前复制到新的分片上
为什么要在 MongoDB 中使用分析器
PDF 出处:第 104–104 页 · 原卷分组:MongoDB 面试题 · 源标题
p104-h05。
MongoDB 中包括了一个可以显示数据库中每个操作性能特点的数据库分析器。通过这个分析器你可以找到比预期慢的查询(或写操作);利用这一信息,比如, 可以确定是否需要添加索引。
解释一下 MongoDB 中的索引是什么
PDF 出处:第 104–104 页 · 原卷分组:MongoDB 面试题 · 源标题
p104-h06。
索引是 MongoDB 中的特殊结构,它以易于遍历的形式存储一小部分数据集。索引按索引中指定的字段的值排序,存储特定字段或一组字段的值
什么是集合(表)
PDF 出处:第 104–104 页 · 原卷分组:MongoDB 面试题 · 源标题
p104-h07。
集合就是一组 MongoDB 文档。它相当于关系型数据库(RDBMS)中的表这种概念。集合位于单独的一个数据库中。一个集合内的多个文档可以有多个不同的字段。一般来说,集合中的文档都有着相同或相关的目的。
什么是 NoSQL 数据库?NoSQL 和 RDBMS 有什么区别?在哪些情况下使用和不使用 NoSQL 数据库?
PDF 出处:第 104–104 页 · 原卷分组:MongoDB 面试题 · 源标题
p104-h08。
NoSQL 是非关系型数据库,NoSQL = Not Only SQL。关系型数据库采用的结构化的数据,NoSQL 采用的是键值对的方式存储数据。在处理非结构化/半结构化的大数据时;在水平方向上进行扩展时,随时应对动态增加的数据项时可以优先考虑。使用 NoSQL 数据库。在考虑数据库的成熟度;支持;分析和商业智能;管理及专业性等问题时,应优先考虑关系型数据库
提及插入文档的命令语法是什么?
PDF 出处:第 104–104 页 · 原卷分组:MongoDB 面试题 · 源标题
p104-h09。
用于插入文档的命令语法是 database.collection.insert(文档)
如果在一个分片(shard)停止或者很慢的时候,我发起一个查询会怎样
PDF 出处:第 105–105 页 · 原卷分组:MongoDB 面试题 · 源标题
p105-h01。
如果一个分片(shard)停止了,除非查询设置了“partial”选项,否则查询会返回一个错误。如果一个分片(shard)响应很慢,MongoDB 则会等待它的响应
如何执行事务/加锁?
PDF 出处:第 105–105 页 · 原卷分组:MongoDB 面试题 · 源标题
p105-h02。
因为 MongoDB 设计就是轻量高性能,所以没有传统的锁和复杂的事务的回滚
Elasticsearch 读取数据
PDF 出处:第 105–105 页 · 原卷分组:Elasticsearch · 源标题
p105-h04。
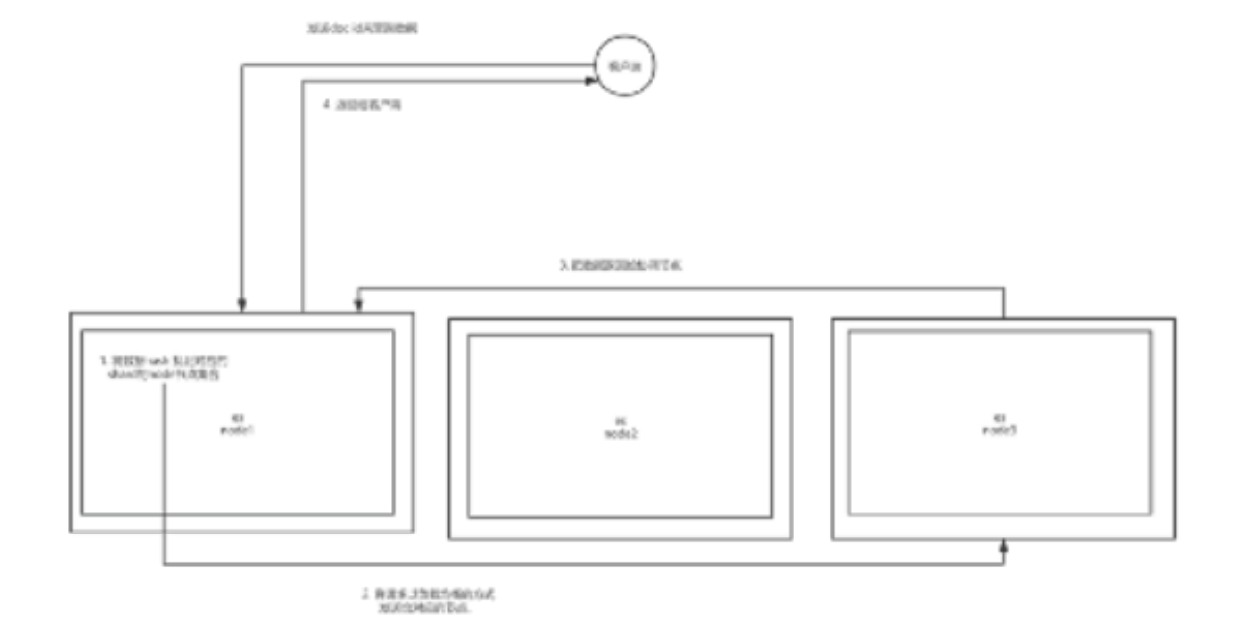
使用 RestFul API 向对应的 node 发送查询请求,根据 did 来判断在哪个 shard 上,返回的是 primary和 replica 的 node 节点集合。这样会负载均衡地把查询发送到对应节点,之后对应节点接收到请求,将document 数据返回协调节点,协调节点把 document 返回给客户端。
您能解释一下 X-Pack for Elasticsearch 的功能和重要性吗
PDF 出处:第 105–105 页 · 原卷分组:Elasticsearch · 源标题
p105-h05。
X-Pack 是与 Elasticsearch 一起安装的扩展程序。 X-Pack 的各种功能包括安全性(基于⻆色的访问,特权/权限,⻆色和用户安全性),监视,报告,警报等。
Elasticsearch 中的节点(比如共 20 个),其中的 10 个选了一个 master,另外 10 个选了另一个 master,怎么办
PDF 出处:第 105–105 页 · 原卷分组:Elasticsearch · 源标题
p105-h06。
当集群 master 候选数量不小于 3 个时,可以通过设置最少投票通过数量(discovery.zen.minimum_master_nodes)超过所有候选节点一半以上来解决脑裂问题;
当候选数量为两个时,只能修改为唯一的一个 master 候选,其他作为data 节点,避免脑裂问题
解释一下 Elasticsearch 集群中的索引的概念?
PDF 出处:第 105–105 页 · 原卷分组:Elasticsearch · 源标题
p105-h07。
Elasticsearch 集群可以包含多个索引,与关系数据库相比,它们相当于数据库表
你可以列出 Elasticsearch 各种类型的分析器吗
PDF 出处:第 106–106 页 · 原卷分组:Elasticsearch · 源标题
p106-h01。
Elasticsearch Analyzer 的类型为内置分析器和自定义分析器。 Standard Analyzer 标准分析器是默认分词器,如果未指定,则使用该分词器。它基于 Unicode 文本分割算法,适用于大多数语言。 Whitespace Analyzer 基于空格字符切词。 Stop Analyzer 在 simple Analyzer 的基础上,移除停用词。 Keyword Analyzer 不切词,将输入的整个串一起返回。自定义分词器的模板自定义分词器的在Mapping 的 Setting 部分设置
http
PUT my\_custom\_index
{
 "settings":{
 "analysis":{
 "char\_filter":{
 },
 "tokenizer":{
 },
 "filter":{
 },
 "analyzer":{
 }
 }
 }
}
其中: “char_filter”:{},——对应字符过滤部分; “tokenizer”:{},——对应文本切分为分词部分; “filter”: {},——对应分词后再过滤部分; “analyzer”:{}——对应分词器组成部分,其中会包含:1. 2. 3
解释一下 Elasticsearch Node?
PDF 出处:第 106–106 页 · 原卷分组:Elasticsearch · 源标题
p106-h02。
节点是 Elasticsearch 的实例。实际业务中,我们会说:ES 集群包含 3 个节点、7 个节点。这里节点实际就是:一个独立的 Elasticsearch 进程,一般将一个节点部署到一台独立的服务器或者虚拟机、容器中。不同节点根据⻆色不同,可以划分为:主节点帮助配置和管理在整个集群中添加和删除节点。数据节点存储数据并执行诸如 CRUD(创建/读取/更新/删除)操作,对数据进行搜索和聚合的操作。客户端节点(或者说:协调节点)将集群请求转发到主节点,将与数据相关的请求转发到数据节点。摄取节点用于在索引之前对文档进行预处理
Elasticsearch 在部署时,对 Linux 的设置有哪些优化方法
PDF 出处:第 106–106 页 · 原卷分组:Elasticsearch · 源标题
p106-h03。
关闭缓存 swap; 堆内存设置为:Min(节点内存/2, 32GB); 设置最大文件句柄数;线程池+队列大小根据业务需要做调整;磁盘存储 raid 方式——存储有条件使用 RAID10,增加单节点性能以及避免单节点存储故障
请解释有关 Elasticsearch 的 NRT
PDF 出处:第 106–106 页 · 原卷分组:Elasticsearch · 源标题
p106-h04。
从文档索引(写入)到可搜索到之间的延迟默认一秒钟,因此 Elasticsearch 是近实时(NRT)搜索平台。也就是说:文档写入,最快一秒钟被索引到,不能再快了。写入调优的时候,我们通常会动态调整: refresh_interval = 30s 或者更达值,以使得写入数据更晚一点时间被搜索到
elasticsearch 的 document 设计
PDF 出处:第 106–106 页 · 原卷分组:Elasticsearch · 源标题
p106-h05。
在使用 es 时避免使用复杂的查询语句(Join、聚合),就是在建立索引时,就根据查询语句建立好对应的元数据