Appearance
Redis、缓存与 Memcached
来源:用户提供的《golang 云原生面试题》PDF。下列为原文完整导入,按主题重排;页码为 PDF 物理页码。技术观点与示例保留原件语境,勘误请结合 校正说明 阅读。
什么是 Redis?
PDF 出处:第 66–66 页 · 原卷分组:redis · 源标题
p066-h02。
Redis 是完全开源免费的,遵守 BSD 协议,是一个高性能的 key-value 数据库。 Redis 与其他 key - value 缓存产品有以下三个特点:
Redis 支持数据的持久化,可以将内存中的数据保存在磁盘中,重启的时候可以再次加载进行使用。
Redis 不仅仅支持简单的 key-value 类型的数据,同时还提供 list, set,zset,hash 等数据结构的存储。
Redis 支持数据的备份,即 master-slave 模式的数据备份。 Redis 优势:
性能极高 – Redis 能读的速度是 110000 次/s,写的速度是 81000 次 /s。
丰富的数据类型 – Redis 支持二进制案例的 Strings, Lists, Hashes, Sets 及 Ordered Sets 数据类型操作。
原子 – Redis 的所有操作都是原子性的,意思就是要么成功执行要么失败完全不执行。单个操作是原子性的。多个操作也支持事务,即原子性,通过 MULTI 和 EXEC 指令包起来。
丰富的特性 – Redis 还支持 publish/subscribe, 通知, key 过期等等特性。
Redis 与其他 key-value 存储有什么不同?
PDF 出处:第 67–67 页 · 原卷分组:redis · 源标题
p067-h01。
Redis 有着更为复杂的数据结构并且提供对他们的原子性操作,这是一个不同于其他数据库的进化路径。Redis 的数据类型都是基于基本数据结构的同时对程序员透明,无需进行额外的抽象。
Redis 运行在内存中但是可以持久化到磁盘,所以在对不同数据集进行高速读写时需要权衡内存,因为数据量不能大于硬件内存。在内存数据库方面的另一个优点是,相比在磁盘上相同的复杂的数据结构,在内存中操作起来非常简单,这样 Redis 可以做很多内部复杂性很强的事情。同时,在磁盘格式方面他们是紧凑的以追加的方式产生的,因为他们并不需要进行随机访问
Redis 的数据类型?
PDF 出处:第 67–67 页 · 原卷分组:redis · 源标题
p067-h02。
Redis 支持五种数据类型:string(字符串),hash(哈希),list(列表),set(集合)及zsetsorted set:有序集合)。我们实际项目中比较常用的是 string,hash 如果你是 Redis 中高级用户,还需要加上下面几种数据结构 HyperLogLog、Geo、Pub/Sub。如果你说还玩过 Redis Module,像BloomFilter,RedisSearch,Redis-ML,面试官得眼睛就开始发亮了。
使用 Redis 有哪些好处?
PDF 出处:第 67–67 页 · 原卷分组:redis · 源标题
p067-h03。
速度快,因为数据存在内存中,类似于 HashMap,HashMap 的优势就是查找和操作的时间复杂度都是 O1)
支持丰富数据类型,支持 string,list,set,Zset,hash 等
支持事务,操作都是原子性,所谓的原子性就是对数据的更改要么全部执行,要么全部不执行
丰富的特性:可用于缓存,消息,按 key 设置过期时间,过期后将会自动删除
Redis 相比 Memcached 有哪些优势?
PDF 出处:第 67–67 页 · 原卷分组:redis · 源标题
p067-h04。
Memcached 所有的值均是简单的字符串,redis 作为其替代者,支持更为丰富的数据类
Redis 的速度比 Memcached 快很
Redis 可以持久化其数据
Memcache 与 Redis 的区别都有哪些?
PDF 出处:第 67–67 页 · 原卷分组:redis · 源标题
p067-h05。
存储方式 Memecache 把数据全部存在内存之中,断电后会挂掉,数据不能超过内存大小。 Redis有部份存在硬盘上,这样能保证数据的持久性。
数据支持类型 Memcache 对数据类型支持相对简单。 Redis 有复杂的数据类型。
使用底层模型不同它们之间底层实现方式以及与客户端之间通信的应用协议不一样。 Redis 直接自己构建了 VM 机制,因为一般的系统调用系统函数的话,会浪费一定的时间去移动和请求
Redis 是单进程单线程的
PDF 出处:第 67–67 页 · 原卷分组:redis · 源标题
p067-h06。
Redis 是单进程单线程的,redis 利用队列技术将并发访问变为串行访问,消除了传统数据库串行控制的开销
一个字符串类型的值能存储最大容量是多少
PDF 出处:第 67–67 页 · 原卷分组:redis · 源标题
p067-h07。
513M
Redis 的持久化机制是什么?各自的优缺点?
PDF 出处:第 68–68 页 · 原卷分组:redis · 源标题
p068-h01。
Redis 提供两种持久化机制 RDB 和 AOF 机制: RDBRedis DataBase)持久化方式:是指用数据集快照的方式半持久化模式)记录 Redis 数据库的所有键值对,在某个时间点将数据写入一个临时文件,持久化结束后,用这个临时文件替换上次持久化的文件,达到数据恢复。优点:
只有一个文件 dump.rdb,方便持久化。
容灾性好,一个文件可以保存到安全的磁盘。
性能最大化,fork 子进程来完成写操作,让主进程继续处理命令,所以是 IO 最大化。使用单独子进程来进行持久化,主进程不会进行任何 IO 操作,保证了 Redis 的高性能)
相对于数据集大时,比 AOF 的启动效率更高。
缺点:
- 数据安全性低。RDB 是间隔一段时间进行持久化,如果持久化之间 Redis 发生故障,会发生数据丢失。所以这种方式更适合数据要求不严谨的时候。
AOFAppend-only file)持久化方式:是指所有的命令行记录以 Redis 命令请求协议的格式完全持久化存储)保存为 aof 文件。优点:
数据安全,aof 持久化可以配置 appendfsync 属性,有 always,每进行一次命令操作就记录到aof 文件中一次。
通过 append 模式写文件,即使中途服务器宕机,可以通过 redis check-aof 工具解决数据一致性问题。
AOF 机制的 rewrite 模式。AOF 文件没被 rewrite 之前(文件过大时会对命令进行合并重写),可以删除其中的某些命令(比如误操作的 flushall))
缺点:
AOF 文件比 RDB 文件大,且恢复速度慢。
数据集大的时候,比 rdb 启动效率低
Redis 常见性能问题和解决方案:
PDF 出处:第 68–68 页 · 原卷分组:redis · 源标题
p068-h02。
Master 最好不要写内存快照,如果 Master 写内存快照,save 命令调度 rdbSave 函数,会阻塞主线程的工作,当快照比较大时对性能影响是非常大的,会间断性暂停服务
如果数据比较重要,某个 Slave 开启 AOF 备份数据,策略设置为每秒同步一(
为了主从复制的速度和连接的稳定性,Master 和 Slave 最好在同一个局域网
尽量避免在压力很大的主库上增加从
主从复制不要用图状结构,用单向链表结构更为稳定,即:Master <- Slave1<- Slave2 <- Slave3…这样的结构方便解决单点故障问题,实现 Slave 对 Master 的替换。如果 Master 挂了,可以立刻启用 Slave1 做 Master,其他不变。
Redis 过期键的删除策略?、
PDF 出处:第 68–69 页 · 原卷分组:redis · 源标题
p068-h03。
定时删除:在设置键的过期时间的同时,创建一个定时器 timer). 让定时器在键的过期时间来临时,立即执行对键的删除操作。
惰性删除:放任键过期不管,但是每次从键空间中获取键时,都检查取得的键是否过期,如果过期的话,就删除该键;如果没有过期,就返回该键。
定期删除:每隔一段时间程序就对数据库进行一次检查,删除里面的过期键。至于要删除多少过期键,以及要检查多少个数据库,则由算法决定。
Redis 的回收策略(淘汰策略)?
PDF 出处:第 69–69 页 · 原卷分组:redis · 源标题
p069-h01。
volatile-lru:从已设置过期时间的数据集(server.db[i].expires)中挑选最近最少使用的数据淘汰
volatile-ttl:从已设置过期时间的数据集(server.db[i].expires)中挑选将要过期的数据淘汰
volatile-random:从已设置过期时间的数据集(server.db[i].expires)中任意选择数据淘汰
allkeys-lru:从数据集(server.db[i].dict)中挑选最近最少使用的数据淘汰
allkeys-random:从数据集(server.db[i].dict)中任意选择数据淘汰
no-enviction(驱逐):禁止驱逐数据注意这里的 6 种机制,volatile 和 allkeys 规定了是对已设置过期时间的数据集淘汰数据还是从全部数据集淘汰数据,后面的 lru、ttl 以及 random 是三种不同的淘汰策略,再加上一种 no-enviction 永不回收的策略。
使用策略规则:
如果数据呈现幂律分布,也就是一部分数据访问频率高,一部分数据访问频率低,则使用 allkeys-lr
如果数据呈现平等分布,也就是所有的数据访问频率都相同,则使用 allkeys-random
为什么 Redis 需要把所有数据放到内存中?
PDF 出处:第 69–69 页 · 原卷分组:redis · 源标题
p069-h03。
- Redis 为了达到最快的读写速度将数据都读到内存中,并通过异步的方式将数据写入磁盘。所以Redis 具有快速和数据持久化的特征。如果不将数据放在内存中,磁盘 I/O 速度为严重影响 Redis的性能。在内存越来越便宜的今天, Redis 将会越来越受欢迎。如果设置了最大使用的内存,则数据已有记录数达到内存限值后不能继续插入新值。
Redis 的同步机制了解么?
PDF 出处:第 69–69 页 · 原卷分组:redis · 源标题
p069-h04。
- Redis 可以使用主从同步,从从同步。第一次同步时,主节点做一次 bgsave,并同时将后续修改操作记录到内存 buffer,待完成后将 rdb 文件全量同步到复制节点,复制节点接受完成后将 rdb镜像加载到内存。加载完成后,再通知主节点将期间修改的操作记录同步到复制节点进行重放就完成了同步过程。
Pipeline 有什么好处,为什么要用 Pipeline?
PDF 出处:第 69–69 页 · 原卷分组:redis · 源标题
p069-h05。
可以将多次 IO 往返的时间缩减为一次,前提是 pipeline 执行的指令之间没有因果相关性。使用 Redis-benchmark 进行压测的时候可以发现影响 Redis 的 QPS 峰值的一个重要因素是 pipeline 批次指令的数目。
是否使用过 Redis 集群,集群的原理是什么?
PDF 出处:第 69–69 页 · 原卷分组:redis · 源标题
p069-h06。
Redis Sentinal 着眼于高可用,在 master 宕机时会自动将 slave 提升为 master,继续提供服务。
Redis Cluster 着眼于扩展性,在单个 Redis 内存不足时,使用 Cluster 进行分片存储。
Redis 集群方案什么情况下会导致整个集群不可用?
PDF 出处:第 70–70 页 · 原卷分组:redis · 源标题
p070-h01。
有 A,B,C 三个节点的集群,在没有复制模型的情况下,如果节点 B 失败了,那么整个集群就会以为缺少5501-11000 这个范围的槽而不可用。
Redis 如何设置密码及验证密码?
PDF 出处:第 70–70 页 · 原卷分组:redis · 源标题
p070-h02。
设置密码:config set requirepass 123456授权密码:auth 123456
说说 Redis 哈希槽的概念?
PDF 出处:第 70–70 页 · 原卷分组:redis · 源标题
p070-h03。
Redis 集群没有使用一致性 hash,而是引入了哈希槽的概念,Redis 集群有 16384 个哈希槽,每个 key通过 CRC16 校验后对 16384 取模来决定放置哪个槽,集群的每个节点负责一部分 hash 槽。
Redis 集群的主从复制模型是怎样的?
PDF 出处:第 70–70 页 · 原卷分组:redis · 源标题
p070-h04。
为了使在部分节点失败或者大部分节点无法通信的情况下集群仍然可用,所以集群使用了主从复制模型,每个节点都会有 N-1 个复制品。
Redis 集群会有写操作丢失吗?为什么?
PDF 出处:第 70–70 页 · 原卷分组:redis · 源标题
p070-h05。
Redis 并不能保证数据的强一致性,这意味这在实际中集群在特定的条件下可能会丢失写操作。
Redis 集群之间是如何复制的?
PDF 出处:第 70–70 页 · 原卷分组:redis · 源标题
p070-h06。
异步复制
Redis 集群最大节点个数是多少?
PDF 出处:第 70–70 页 · 原卷分组:redis · 源标题
p070-h07。
16384 个。
Redis 集群如何选择数据库?
PDF 出处:第 70–70 页 · 原卷分组:redis · 源标题
p070-h08。
Redis 集群目前无法做数据库选择,默认在 0 数据库。
怎么测试 Redis 的连通性
PDF 出处:第 70–70 页 · 原卷分组:redis · 源标题
p070-h09。
使用 ping 命令。
怎么理解 Redis 事务?
PDF 出处:第 70–70 页 · 原卷分组:redis · 源标题
p070-h10。
事务是一个单独的隔离操作:事务中的所有命令都会序列化、按顺序地执行。事务在执行的过程中,不会被其他客户端发送来的命令请求所打断。
事务是一个原子操作:事务中的命令要么全部被执行,要么全部都不执行。
Redis 事务相关的命令有哪几个?
PDF 出处:第 70–70 页 · 原卷分组:redis · 源标题
p070-h11。
MULTI、EXEC、DISCARD、WATCH
Redis key 的过期时间和永久有效分别怎么设置?
PDF 出处:第 70–70 页 · 原卷分组:redis · 源标题
p070-h12。
EXPIRE 和 PERSIST 命令。
Redis 如何做内存优化?
PDF 出处:第 71–71 页 · 原卷分组:redis · 源标题
p071-h01。
尽可能使用散列表(hashes),散列表(是说散列表里面存储的数少)使用的内存非常小,所以你应该尽可能的将你的数据模型抽象到一个散列表里面。比如你的 web 系统中有一个用户对象,不要为这个用户的名称,姓氏,邮箱,密码设置单独的 key,而是应该把这个用户的所有信息存储到一张散列表里面。
Redis 回收进程如何工作的?
PDF 出处:第 71–71 页 · 原卷分组:redis · 源标题
p071-h02。
一个客户端运行了新的命令,添加了新的数据。Redi 检查内存使用情况,如果大于 maxmemory 的限制, 则根据设定好的策略进行回收。一个新的命令被执行,等等。所以我们不断地穿越内存限制的边界,通过不断达到边界然后不断地回收回到边界以下。如果一个命令的结果导致大量内存被使用(例如很大的集合的交集保存到一个新的键),不用多久内存限制就会被这个内存使用量超越。
都有哪些办法可以降低 Redis 的内存使用情况呢?
PDF 出处:第 71–71 页 · 原卷分组:redis · 源标题
p071-h03。
如果你使用的是 32 位的 Redis 实例,可以好好利用 Hash,list,sorted set,set 等集合类型数据,因为通常情况下很多小的 Key-Value 可以用更紧凑的方式存放到一起。
Redis 的内存用完了会发生什么?
PDF 出处:第 71–71 页 · 原卷分组:redis · 源标题
p071-h04。
如果达到设置的上限,Redis 的写命令会返回错误信息(但是读命令还可以正常返回。)或者你可以将Redis 当缓存来使用配置淘汰机制,当 Redis 达到内存上限时会冲刷掉旧的内容。
一个 Redis 实例最多能存放多少的 keys?
PDF 出处:第 71–71 页 · 原卷分组:redis · 源标题
p071-h05。
List、Set、 Sorted Set 他们最多能存放多少元素?理论上 Redis 可以处理多达 2的32次方的 keys,并且在实际中进行了测试,每个实例至少存放了 2 亿 5 千万的 keys。我们正在测试一些较大的值。任何list、 set、和 sorted set 都可以放 232 个元素。换句话说,Redis 的存储极限是系统中的可用内存值。
MySQL 里有 2000w 数据,Redis 中只存 20w 的数据,如何保证 Redis 中的数据都是热点数据?
PDF 出处:第 71–71 页 · 原卷分组:redis · 源标题
p071-h06。
Redis 内存数据集大小上升到一定大小的时候,就会施行数据淘汰策略。相关知识:Redis 提供 6 种数据淘汰策略: volatile-lru:从已设置过期时间的数据集(server.db[i].expires)中挑选最近最少使用的数据淘汰volatile-ttl:从已设置过期时间的数据集(server.db[i].expires)中挑选将要过期的数据淘汰volatile-random:从已设置过期时间的数据集(server.db[i].expires)中任意选择数据淘汰allkeys-lru:从数据集(server.db[i].dict)中挑选最近最少使用的数据淘汰allkeys-random:从数据集(server.db[i].dict)中任意选择数据淘汰no-enviction(驱逐):禁止驱逐数据
Redis 最适合的场景?
PDF 出处:第 71–72 页 · 原卷分组:redis · 源标题
p071-h07。
会话缓存(Session Cache)最常用的一种使用 Redis 的情景是会话缓存(session cache)。用Redis 缓存会话比其他存储(如 Memcached)的优势在于:Redis 提供持久化。当维护一个不是严格要求一致性的缓存时,如果用户的购物车信息全部丢失,大部分人都会不高兴的,现在,他们还会这样吗?幸运的是,随着 Redis 这些年的改进,很容易找到怎么恰当的使用 Redis 来缓存会话的文档。甚至广为人知的商业平台 Magento 也提供 Redis 的插件。
全页缓存(FPC)除基本的会话 token 之外,Redis 还提供很简便的 FPC 平台。回到一致性问题,即使重启了 Redis 实例,因为有磁盘的持久化,用户也不会看到页面加载速度的下降,这是一个极大改进,类似 PHP 本地 FPC。再次以 Magento 为例,Magento 提供一个插件来使用 Redis 作为全页缓存后端。此外,对 WordPress 的用户来说,Pantheon 有一个非常好的插件 wp-redis,这个插件能帮助你以最快速度加载你曾浏览过的页面。
队列 Redis 在内存存储引擎领域的一大优点是提供 list 和 set 操作,这使得 Redis 能作为一个很好的消息队列平台来使用。Redis 作为队列使用的操作,就类似于本地程序语言(如 Python)对 list的 push/pop 操作。如果你快速的在 Google 中搜索“Redis queues”,你马上就能找到大量的开源项目,这些项目的目的就是利用 Redis 创建非常好的后端工具,以满足各种队列需求。例如, Celery 有一个后台就是使用 Redis 作为 broker,你可以从这里去查看。
排行榜/计数器 Redis 在内存中对数字进行递增或递减的操作实现的非常好。集合(Set)和有序集合(Sorted Set)也使得我们在执行这些操作的时候变的非常简单,Redis 只是正好提供了这两种数据结构。所以,我们要从排序集合中获取到排名最靠前的 10 个用户–我们称之为“user_scores”,我们只需要像下面一样执行即可:当然,这是假定你是根据你用户的分数做递增的排序。如果你想返回用户及用户的分数,你需要这样执行: ZRANGE user_scores 0 10 WITHSCORES Agora Games 就是一个很好的例子,用 Ruby 实现的,它的排行榜就是使用 Redis来存储数据的,你可以在这里看到。
发布/订阅最后(但肯定不是最不重要的)是 Redis 的发布/订阅功能。发布/订阅的使用场景确实非常多。我已看见人们在社交网络连接中使用,还可作为基于发布/订阅的脚本触发器,甚至用Redis 的发布/订阅功能来建立聊天系统!
假如 Redis 里面有 1 亿个 key,其中有 10w 个 key 是以某个固定的已知的前缀开头的,如果将它们全部找出来?
PDF 出处:第 72–72 页 · 原卷分组:redis · 源标题
p072-h01。
使用 keys 指令可以扫出指定模式的 key 列表。对方接着追问:如果这个 Redis 正在给线上的业务提供服务,那使用 keys 指令会有什么问题?这个时候你要回答 Redis 关键的一个特性:Redis 的单线程的。keys 指令会导致线程阻塞一段时间,线上服务会停顿,直到指令执行完毕,服务才能恢复。这个时候可以使用 scan 指令,scan 指令可以无阻塞的提取出指定模式的 70 key 列表,但是会有一定的重复概率,在客户端做一次去重就可以了,但是整体所花费的时间会比直接用 keys 指令长。
如果有大量的 key 需要设置同一时间过期,一般需要注意什么?
PDF 出处:第 72–72 页 · 原卷分组:redis · 源标题
p072-h02。
如果大量的 key 过期时间设置的过于集中,到过期的那个时间点,Redis 可能会出现短暂的卡顿现象。一般需要在时间上加一个随机值,使得过期时间分散一些。
使用过 Redis 做异步队列么,你是怎么用的?
PDF 出处:第 72–72 页 · 原卷分组:redis · 源标题
p072-h03。
一般使用 list 结构作为队列,rpush 生产消息,lpop 消费消息。当 lpop 没有消息的时候,要适当 sleep一会再重试。如果对方追问可不可以不用 sleep 呢? list 还有个指令叫 blpop,在没有消息的时候,它会阻塞住直到消息到来。如果对方追问能不能生产一次消费多次呢?使用 pub/sub 主题订阅者模式,可以实现 1:N 的消息队列。如果对方追问 pub/sub 有什么缺点?在消费者下线的情况下,生产的消息会丢失,得使用专业的消息队列如 RabbitMQ 等。如果对方追问 Redis 如何实现延时队列?使用 sortedset,拿时间戳作为 score,消息内容作为 key 调用 zadd 来生产消息,消费者用zrangebyscore 指令获取 N 秒之前的数据轮询进行处理。
使用过 Redis 分布式锁么,它是什么回事先拿
PDF 出处:第 73–73 页 · 原卷分组:redis · 源标题
p073-h01。
setnx 来争抢锁,抢到之后,再用 expire 给锁加一个过期时间防止锁忘记了释放。这时候对方会告诉你说你回答得不错,然后接着问如果在 setnx 之后执行 expire 之前进程意外 crash 或者要重启维护了,那会怎么样?可以同时把 setnx 和 expire 合成一条指令来用的!
缓存如何实现高性能?
PDF 出处:第 83–83 页 · 原卷分组:缓存 · 源标题
p083-h02。
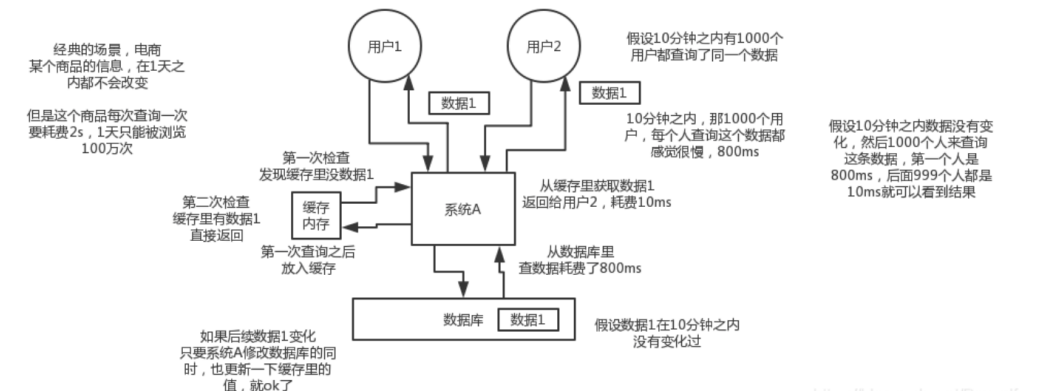
缓存如何实现高并发
PDF 出处:第 83–83 页 · 原卷分组:缓存 · 源标题
p083-h03。
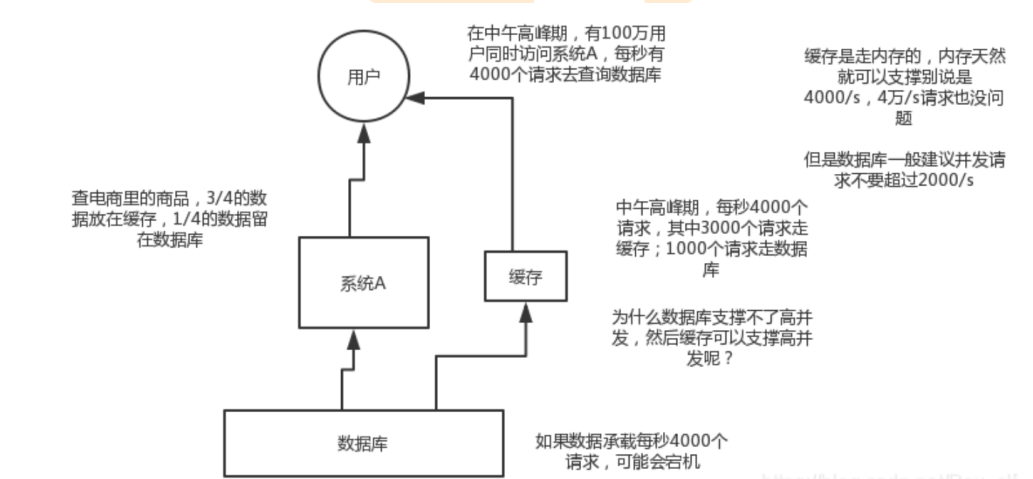
Redis 和 Memcached 的区别
PDF 出处:第 83–83 页 · 原卷分组:缓存 · 源标题
p083-h04。
Redis 拥有更多的数据结构和丰富的数据操作 Redis 内存利用率高于 Memcached Redis 是单线程, Memcached 是多线程,在存储大数据的情况下,Redis 比 Memcached 稍有逊色 Memcached 没有原生的集群模式,Redis 官方支持 Redis Cluster 集群模式
用缓存可能出现的问题
PDF 出处:第 83–83 页 · 原卷分组:缓存 · 源标题
p083-h05。
数据不一致
缓存雪崩
缓存穿透
缓存并发竞争
当查询缓存报错,怎么提高可用性?
PDF 出处:第 83–83 页 · 原卷分组:缓存 · 源标题
p083-h06。
缓存可以极大的提高查询性能,但是缓存数据丢失和缓存不可用不能影响应用的正常工作。因此,一般情况下,如果缓存出现异常,需要手动捕获这个异常,并且记录日志,并且从数据库查询数据返回给用户,而不应该导致业务不可用
如果避免缓存”穿透”的问题?
PDF 出处:第 84–84 页 · 原卷分组:缓存 · 源标题
p084-h01。
缓存穿透,是指查询一个一定不存在的数据,由于缓存是不命中时被动写,并且处于容错考虑,如果从DB 查不到数据则不写入缓存,这将导致这个不存在的数据每次请求都要到 DB 去查询,失去了缓存的意义。如何解决有两种方案可以解决:
方案一,缓存空对象。当从 DB 查询数据为空,我们仍然将这个空结果进行缓存,具体的值需要使用特殊的标识,能和真正缓存的数据区分开。另外,需要设置较短的过期时间,一般建议不要超过5 分钟。
方案二,BloomFilter 布隆过滤器。在缓存服务的基础上,构建 BloomFilter 数据结构,在BloomFilter 中存储对应的 KEY 是否存在,如果存在,说明该 KEY 对应的值不为空
如何避免缓存“雪崩”的问题
PDF 出处:第 84–84 页 · 原卷分组:缓存 · 源标题
p084-h02。
缓存雪崩,是指缓存由于某些原因无法提供服务( 例如,缓存挂掉了 ),所有请求全部达到 DB 中,导致DB 负荷大增,最终挂掉的情况。预防和解决缓存雪崩的问题,可以从以下多个方面进行共同着手。 1)缓存高可用:通过搭建缓存的高可用,避免缓存挂掉导致无法提供服务的情况,从而降低出现缓存雪崩的情况。假设我们使用 Redis 作为缓存,则可以使用 Redis Sentinel 或 Redis Cluster 实现高可用。 2)本地缓存:如果使用本地缓存时,即使分布式缓存挂了,也可以将 DB 查询到的结果缓存到本地,避免后续请求全部到达 DB 中。如果我们使用 JVM,则可以使用 Ehcache、Guava Cache 实现本地缓存的功能。
如何避免缓存“击穿”的问题
PDF 出处:第 84–84 页 · 原卷分组:缓存 · 源标题
p084-h03。
缓存击穿,是指某个极度“热点”数据在某个时间点过期时,恰好在这个时间点对这个 KEY 有大量的并发请求过来,这些请求发现缓存过期一般都会从 DB 加载数据并回设到缓存,但是这个时候大并发的请求可能会瞬间 DB 压垮。对于一些设置了过期时间的 KEY,如果这些 KEY 可能会在某些时间点被超高并发地访问,是一种非常“热点”的数据。这个时候,需要考虑这个问题。区别:
和缓存“雪崩“”的区别在于,前者针对某一 KEY 缓存,后者则是很多 KEY。
和缓存“穿透“”的区别在于,这个 KEY 是真实存在对应的值的
有两种方案可以解决:
方案一,使用互斥锁。请求发现缓存不存在后,去查询 DB 前,使用分布式锁,保证有且只有一个线程去查询 DB,并更新到缓存。
方案二,手动过期。缓存上从不设置过期时间,功能上将过期时间存在 KEY 对应的 VALUE 里。流程如下:
获取缓存。通过 VALUE 的过期时间,判断是否过期。如果未过期,则直接返回;如果已过期,继续往下执行。
通过一个后台的异步线程进行缓存的构建,也就是“手动”过期。通过后台的异步线程,保证有且只有一个线程去查询 DB。
同时,虽然 VALUE 已经过期,还是直接返回。通过这样的方式,保证服务的可用性,虽然损失了一定的时效性。
什么是缓存预热?如何实现缓存预热
PDF 出处:第 85–85 页 · 原卷分组:缓存 · 源标题
p085-h01。
缓存预热在刚启动的缓存系统中,如果缓存中没有任何数据,如果依靠用户请求的方式重建缓存数据,那么对数据库的压力非常大,而且系统的性能开销也是巨大的。此时,最好的策略是启动时就把热点数据加载好。这样,用户请求时,直接读取的就是缓存的数据,而无需去读取 DB 重建缓存数据。举个例子,热门的或者推荐的商品,需要提前预热到缓存中如何实现一般来说,有如下几种方式来实现:数据量不大时,项目启动时,自动进行初始化。写个修复数据脚本,手动执行该脚本。写个管理界面,可以手动点击,预热对应的数据到缓存中。
缓存数据的淘汰策略有哪些?
PDF 出处:第 85–85 页 · 原卷分组:缓存 · 源标题
p085-h02。
除了缓存服务器自带的缓存自动失效策略之外,我们还可以根据具体的业务需求进行自定义的“手动”缓存淘汰,常见的策略有两种: 1、定时去清理过期的缓存。 2、当有用户请求过来时,再判断这个请求所用到的缓存是否过期,过期的话就去底层系统得到新数据并更新缓存。两者各有优劣,第一种的缺点是维护大量缓存的 key 是比较麻烦的,第二种的缺点就是每次用户请求过来都要判断缓存失效,逻辑相对比较复杂!具体用哪种方案,大家可以根据自己的应用场景来权衡。
Memcached 的多线程是什么?如何使用它们?
PDF 出处:第 101–101 页 · 原卷分组:Memcached · 源标题
p101-h03。
线程就是定律(threads rule)!在 Steven Grimm 和 Facebook 的努力下, Memcached 1.2 及更高版本拥有了多线程模式。多线程模式允许 Memcached 能够充分利用多个 CPU,并在 CPU 之间共享所有的缓存数据。 Memcached 使用一种简单的锁机制来保证数据更新操作的互斥。相比在同一个物理机器上运行多个 Memcached 实例,这种方式能够更有效地处理 multi gets。如果你的系统负载并不重,也许你不需要启用多线程工作模式。如果你在运行一个拥有大规模硬件的、庞大的网站,你将会看到多线程的好处。简单地总结一下:命令解析(Memcached 在这里花了大部分时间)可以运行在多线程模式下。Memcached 内部对数据的操作是基于很多全局锁的(因此这部分工作不是多线程的)。未来对多线程模式的改进,将移除大量的全局锁,提高 Memcached 在负载极高的场景下的性能。
Memcached 是什么,有什么作用
PDF 出处:第 101–101 页 · 原卷分组:Memcached · 源标题
p101-h04。
Memcached 是一个开源的,高性能的内存绶存软件,从名称上看 Mem 就是内存的意思,而 Cache 就是缓存的意思。Memcached 的作用:通过在事先规划好的内存空间中临时绶存数据库中的各类数据,以达到减少业务对数据库的直接高并发访问,从而达到提升数据库的访问性能,加速网站集群动态应用服务的能力
Memcached 与 Redis 的区别?
PDF 出处:第 101–102 页 · 原卷分组:Memcached · 源标题
p101-h05。
Redis 不仅仅支持简单的 K/V类型的数据,同时还提供 list,set,zset, hash 等数据结构的存储。而 memcache 只支持简单数据类型,需要客户端自己处理复杂对象。
Redis 支持数据的持久化,可以将内存中的数据保持在磁盘中,重启的时候可以再次加载进行使用(PS:持久化在 rdb、aof)。
由于 Memcache 没有持久化机制,因此宕机所有缓存数据失效。Redis 配置为持久化,宕机重启后,将自动加载宕机时刻的数据到缓存系统中。具有更好的灾备机制。
Memcache 可以使用 Magent 在客户端进行一致性 hash 做分布式。 Redis 支持在服务器端做分布式(PS:Twemproxy/Codis/Redis-cluster 多种分布式实现方式)。
Memcached 的简单限制就是键(key)和 Value 的限制。最大键⻓为 250 个字符。可以接受的储存数据不能超过 1MB(可修改配置文件变大),因为这是典型 slab 的最大值,不适合虚拟机使用。而 Redis 的 Key ⻓度支持到 512K。
Redis 使用的是单线程模型,保证了数据按顺序提交。Memcache 需要使用 cas 保证数据一致性。 CAS(Check and Set)是一个确保并发一致性的机制,属于“乐观锁”范畴;原理很简单:拿版本号,操作,对比版本号,如果一致就操作,不一致就放弃任何操作。
CPU 利用:由于 Redis 只使用单核,而 Memcached 可以使用多核,所以平均每一个核上 Redis在存储小数据时比 Memcached 性能更高。而在 100k 以上的数据中,Memcached 性能要高于Redis。
Memcached 内存管理:使用 Slab Allocation。原理相当简单,预先分配一系列大小固定的组,然后根据数据大小选择最合适的块存储。避免了内存碎片。(缺点:不能变⻓,浪费了一定空间) Memcached 默认情况下下一个 slab 的最大值为前一个的 1.25 倍。
Redis 内存管理: Redis 通过定义一个数组来记录所有的内存分配情况, Redis 采用的是包装的malloc/free,相较于 Memcached 的内存管理方法来说,要简单很多。由于 malloc 首先以链表的方式搜索已管理的内存中可用的空间分配,导致内存碎片比较多。
如果缓存数据在导出导入之间过期了,你又怎么处理这些数据呢
PDF 出处:第 102–102 页 · 原卷分组:Memcached · 源标题
p102-h01。
因此,批量导出导入数据并不像你想象中的那么有用。不过在一个场景倒是很有用。如果你有大量的从不变化的数据,并且希望缓存很快热(warm)起来,批量导入缓存数据是很有帮助的。虽然这个场景并不典型,但却经常发生,因此我们会考虑在将来实现批量导出导入的功能。如果一个 Memcached 节点 down 了让你很痛苦,那么你还会陷入其他很多麻烦。你的系统太脆弱了。你需要做一些优化工作。比如处理”惊群”问题(比如 Memcached 节点都失效了,反复的查询让你的数据库不堪重负…这个问题在 FAQ 的其他提到过),或者优化不好的查询。记住,Memcached 并不是你逃避优化查询的借口
如何实现集群中的 session 共享存储
PDF 出处:第 102–103 页 · 原卷分组:Memcached · 源标题
p102-h02。
Session 是运行在一台服务器上的,所有的访问都会到达我们的唯一服务器上,这样我们可以根据客户端传来的 sessionID,来获取 session,或在对应 Session 不存在的情况下(session 生命周期到了/用户第一次登录),创建一个新的 Session;但是,如果我们在集群环境下,假设我们有两台服务器 A, B,用户的请求会由 Nginx 服务器进行转发(别的方案也是同理),用户登录时,Nginx 将请求转发至服务器 A 上,A 创建了新的 session,并将 SessionID 返回给客户端,用户在浏览其他⻚面时,客户端验证登录状态, Nginx 将请求转发至服务器 B,由于 B 上并没有对应客户端发来 sessionId 的 session,所以会重新创建一个新的 session,并且再将这个新的 sessionID 返回给客户端,这样,我们可以想象一下,用户每一次操作都有 1/2 的概率进行再次的登录,这样不仅对用户体验特别差,还会让服务器上的 session 激增,加大服务器的运行压力。为了解决集群环境下的 seesion 共享问题,共有 4 种解决方案:
粘性 session 粘性 session 是指 Ngnix 每次都将同一用户的所有请求转发至同一台服务器上,即将用户与服务器绑定
服务器 session 复制即每次 session 发生变化时,创建或者修改,就广播给所有集群中的服务器,使所有的服务器上的 session 相同。
session 共享缓存 session,使用 Redis, Memcached。
session 持久化将 session 存储至数据库中,像操作数据一样才做 session。
Memcached 和 MySQL 的 query cache 相比,有什么优缺点
PDF 出处:第 103–103 页 · 原卷分组:Memcached · 源标题
p103-h01。
把 Memcached 引入应用中,还是需要不少工作量的。MySQL 有个使用方便的 query cache,可以自动地缓存 SQL 查询的结果,被缓存的 SQL 查询可以被反复地快速执行。Memcached 与之相比,怎么样呢?MySQL 的 query cache 是集中式的,连接到该 query cache 的 MySQL 服务器都会受益
当你修改表时,MySQL 的 query cache 会立刻被刷新(flush)。存储一个 Memcached item 只需要很少的时间,但是当写操作很频繁时,MySQL 的 query cache 会经常让所有缓存数据都失效
在多核 CPU 上,MySQL 的 query cache 会遇到扩展问题(scalability issues)。在多核 CPU 上, query cache 会增加一个全局锁(global lock), 由于需要刷新更多的缓存数据,速度会变得更慢
在 MySQL 的 query cache 中,我们是不能存储任意的数据的(只能是 SQL 查询结果)。而利用Memcached,我们可以搭建出各种高效的缓存。比如,可以执行多个独立的查询,构建出一个用户对象(user object),然后将用户对象缓存到 Memcached 中。而 query cache 是 SQL 语句级别的,不可能做到这一点。在小的网站中,query cache 会有所帮助,但随着网站规模的增加, query cache 的弊将大于利。
query cache 能够利用的内存容量受到 MySQL 服务器空闲内存空间的限制。给数据库服务器增加更多的内存来缓存数据,固然是很好的。但是,有了 Memcached,只要你有空闲的内存,都可以用来增加 Memcached 集群的规模,然后你就可以缓存更多的数据
Memcached 是原子的吗?
PDF 出处:第 103–103 页 · 原卷分组:Memcached · 源标题
p103-h02。
所有的被发送到 Memcached 的单个命令是完全原子的。如果你针对同一份数据同时发送了一个 set 命令和一个 get 命令,它们不会影响对方。它们将被串行化、先后执行。即使在多线程模式,所有的命令都是原子的,除非程序有 bug。命令序列不是原子的。如果你通过 get 命令获取了一个 item,修改了它,然后想把它 set 回 Memcached,我们不保证这个 item 没有被其他进程(process,未必是操作系统中的进程)操作过。在并发的情况下,你也可能覆写了一个被其他进程 set 的 item。 Memcached
1.2.5 以及更高版本,提供了 gets 和 cas 命令,它们可以解决上面的问题。如果你使用 gets 命令查询某个 key 的 item,Memcached 会给你返回该 item 当前值的唯一标识。如果你覆写了这个 item 并想把它写回到 Memcached 中,你可以通过 cas 命令把那个唯一标识一起发送给 Memcached。如果该item 存放在 Memcached 中的唯一标识与你提供的一致,你的写操作将会成功。如果另一个进程在这期间也修改了这个 item,那么该 item 存放在 Memcached 中的唯一标识将会改变,你的写操作就会失败
Memcached 能够更有效地使用内存吗
PDF 出处:第 103–103 页 · 原卷分组:Memcached · 源标题
p103-h03。
Memcache 客户端仅根据哈希算法来决定将某个 key 存储在哪个节点上,而不考虑节点的内存大小。因此,你可以在不同的节点上使用大小不等的缓存。但是一般都是这样做的:拥有较多内存的节点上可以运行多个 Memcached 实例,每个实例使用的内存跟其他节点上的实例相同
Memcached 的内存分配器是如何工作的?为什么不适用malloc/free?为何要使用 slabs?
PDF 出处:第 104–104 页 · 原卷分组:Memcached · 源标题
p104-h01。
实际上,这是一个编译时选项。默认会使用内部的 slab 分配器。你确实确实应该使用内建的 slab 分配器。最早的时候,Memcached 只使用 malloc/free 来管理内存。然而,这种方式不能与 OS 的内存管理以前很好地工作。反复地 malloc/free 造成了内存碎片,OS 最终花费大量的时间去查找连续的内存块来满足 malloc 的请求,而不是运行 Memcached 进程。如果你不同意,当然可以使用 malloc。 slab分配器就是为了解决这个问题而生的。内存被分配并划分成 chunks,一直被重复使用。因为内存被划分成大小不等的 slabs,如果 item 的大小与被选择存放它的 slab 不是很合适的话,就会浪费一些内存。 Steven Grimm 正在这方面已经做出了有效的改进