Appearance
Go 并发、Channel 与同步原语
来源:用户提供的《golang 云原生面试题》PDF。下列为原文完整导入,按主题重排;页码为 PDF 物理页码。技术观点与示例保留原件语境,勘误请结合 校正说明 阅读。
Go 当中同步锁有什么特点?作用是什么
PDF 出处:第 1–1 页 · 原卷分组:golang基础 · 源标题
p001-h05。
当一个 Goroutine(协程)获得了 Mutex 后,其他 Goroutine(协程)就只能乖乖的等待,除非该Goroutine 释放了该 Mutex。RWMutex 在读锁占用的情况下,会阻止写,但不阻止读 RWMutex。在写锁占用情况下,会阻止任何其他 Goroutine(无论读和写)进来,整个锁相当于由该 Goroutine 独占同步锁的作用是保证资源在使用时的独有性,不会因为并发而导致数据错乱,保证系统的稳定性。
Go 语言当中 Channel(通道)有什么特点,需要注意什么?
PDF 出处:第 1–2 页 · 原卷分组:golang基础 · 源标题
p001-h06。
1如果给个nil的channel发送数据会造成永远阻塞
如果给一个 nil 的 channel 发送数据,会造成永远阻塞。
如果从一个 nil 的 channel 中接收数据,也会造成永久阻塞。
给一个已经关闭的 channel 发送数据,会引起 panic
从一个已经关闭的 channel 接收数据,如果缓冲区中为空,则返回一个零值。
Go 语言当中 Channel 缓冲有什么特点?
PDF 出处:第 2–2 页 · 原卷分组:golang基础 · 源标题
p002-h01。
无缓冲的 channel 是同步的,而有缓冲的 channel 是非同步的。
关于select机制
PDF 出处:第 2–2 页 · 原卷分组:golang基础 · 源标题
p002-h07。
select机制用来处理异步IO问题;
select机制最大的一条限制就是每个case语句里必须是一个IO操作
golang在语言级别支持select关键字
Log包线程安全吗
PDF 出处:第 3–3 页 · 原卷分组:golang基础 · 源标题
p003-h06。
Golang的标准库提供了log的机制,但是该模块的功能较为简单(看似简单,其实他有他的设计思路)。在输出的位置做了线程安全的保护
Goroutine和线程的区别?
PDF 出处:第 4–4 页 · 原卷分组:golang基础 · 源标题
p004-h02。
从调度上看,goroutine的调度开销远远小于线程调度开销。 OS的线程由OS内核调度,每隔几毫秒,一个硬件时钟中断发到CPU,CPU调用一个调度器内核函数。这个函数暂停当前正在运行的线程,把他的寄存器信息保存到内存中,查看线程列表并决定接下来运行哪一个线程,再从内存中恢复线程的注册表信息,最后继续执行选中的线程。这种线程切换需要一个完整的上下文切换:即保存一个线程的状态到内存,再恢复另外一个线程的状态,最后更新调度器的数据结构。某种意义上,这种操作还是很慢的。 Go运行的时候包涵一个自己的调度器,这个调度器使用一个称为一个M:N调度技术,m个goroutine到n个os线程(可以用GOMAXPROCS来控制n的数量),Go的调度器不是由硬件时钟来定期触发的,而是由特定的go语言结构来触发的,他不需要切换到内核语境,所以调度一个goroutine比调度一个线程的成本低很多。从栈空间上,goroutine的栈空间更加动态灵活。每个OS的线程都有一个固定大小的栈内存,通常是2MB,栈内存用于保存在其他函数调用期间哪些正在执行或者临时暂停的函数的局部变量。这个固定的栈大小,如果对于goroutine来说,可能是一种巨大的浪费。作为对比 goroutine在生命周期开始只有一个很小的栈,典型情况是2KB, 在go程序中,一次创建十万左右的goroutine也不罕⻅ (2KB*100,000=200MB)。而且goroutine的栈不是固定大小,它可以按需增大和缩小,最大限制可以到 1GB。 goroutine没有一个特定的标识。在大部分支持多线程的操作系统和编程语言中,线程有一个独特的标识,通常是一个整数或者指针,这个特性可以让我们构建一个线程的局部存储,本质是一个全局的map,以线程的标识作为键,这样每个线程可以独立使用这个 map存储和获取值,不受其他线程干扰。 goroutine中没有可供程序员访问的标识,原因是一种纯函数的理念,不希望滥用线程局部存储导致一个不健康的超距作用,即函数的行为不仅取决于它的参数,还取决于运行它的线程标识。
介绍一下 Channel
PDF 出处:第 6–6 页 · 原卷分组:golang基础 · 源标题
p006-h04。
Go 语言中,不要通过共享内存来通信,而要通过通信来实现内存共享。Go 的 CSP(Communicating Sequential Process)并发模型,中文可以叫做通信顺序进程,是通过 goroutine 和 channel 来实现的。 channel 收发遵循先进先出 FIFO 的原则。分为有缓冲区和无缓冲区,channel 中包括 buffer、sendx 和recvx 收发的位置(ring buffer 记录实现)、sendq、 recv。当 channel 因为缓冲区不足而阻塞了队列,则使用双向链表存储
Channel 的 ring buffer 实现
PDF 出处:第 6–7 页 · 原卷分组:golang基础 · 源标题
p006-h05。
channel 中使用了 ring buffer(环形缓冲区) 来缓存写入的数据。ring buffer 有很多好处,而且非常适合用来实现 FIFO 式的固定长度队列。在 channel 中,ring buffer 的实现如下:
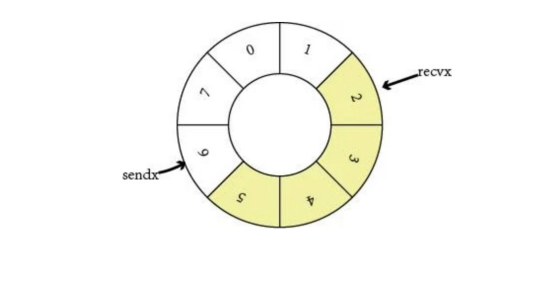
上图展示的是一个缓冲区为 8 的 channel buffer,recvx 指向最早被读取的数据,sendx 指向再次写入时插入的位置。
for循环select时,如果通道已经关闭会怎么样?如果select中的case只有一个,又会怎么样?
PDF 出处:第 7–7 页 · 原卷分组:golang基础 · 源标题
p007-h01。
for循环select时,如果其中一个case通道已经关闭,则每次都会执行到这个case。
如果select里边只有一个case,而这个case被关闭了,则会出现死循环。
go语言的并发机制以及它所使用的CSP并发模型
PDF 出处:第 24–25 页 · 原卷分组:进阶-并发编程 · 源标题
p024-h02。
CSP模型是上个世纪七十年代提出的,不同于传统的多线程通过共享内存来通信,CSP讲究的是“以通信的方式来共享内存”。用于描述两个独立的并发实体通过共享的通讯 channel(管道)进行通信的并发模型。 CSP中channel是第一类对象,它不关注发送消息的实体,而关注与发送消息时使用的channel。 Golang中channel 是被单独创建并且可以在进程之间传递,它的通信模式类似于 boss-worker 模式的,一个实体通过将消息发送到channel 中,然后又监听这个 channel 的实体处理,两个实体之间是匿名的,这个就实现实体中间的解耦,其中 channel 是同步的一个消息被发送到 channel 中,最终是一定要被另外的实体消费掉的,在实现原理上其实类似一个阻塞的消息队列。 Goroutine 是Golang实际并发执行的实体,它底层是使用协程(coroutine)实现并发,coroutine是一种运行在用户态的用户线程,类似于 greenthread,go底层选择使用coroutine的出发点是因为,它具有以下特点:
用户空间避免了内核态和用户态的切换导致的成本。
可以由语言和框架层进行调度。
更小的栈空间允许创建大量的实例
Golang中的Goroutine的特性: Golang内部有三个对象: P对象(processor) 代表上下文(或者可以认为是cpu),M(work thread)代表工作线程,G对象(goroutine). 正常情况下一个cpu对象启一个工作线程对象,线程去检查并执行goroutine对象。碰到goroutine对象阻塞的时候,会启动一个新的工作线程,以充分利用cpu资源。所有有时候线程对象会比处理器对象多很多我们用如下图分别表示P、M、G:
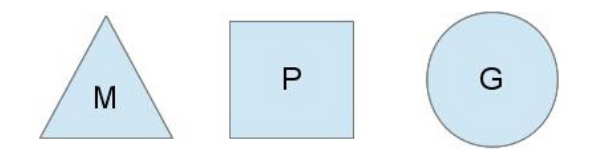
G(Goroutine):我们所说的协程,为用户级的轻量级线程,每个Goroutine对象中的sched保存着其上下文信息.M(Machine):对内核级线程的封装,数量对应真实的CPU数(真正干活的对象).P(Processor):即为G和M的调度对象,用来调度G和M之间的关联关系,其数量可通过GOMAXPROCS()来设置,默认为核心数.在单核情况下,所有Goroutine运行在同一个线程(M0)中,每一个线程维护一个上下文(P),任何时刻,一个上下文中只有一个Goroutine,其他Goroutine在runqueue中等待。一个Goroutine运行完自己的时间片后,让出上下文,自己回到runqueue中(如下图所示)。当正在运行的G0阻塞的时候(可以需要IO),会再创建一个线程(M1),P转到新的线程中去运行
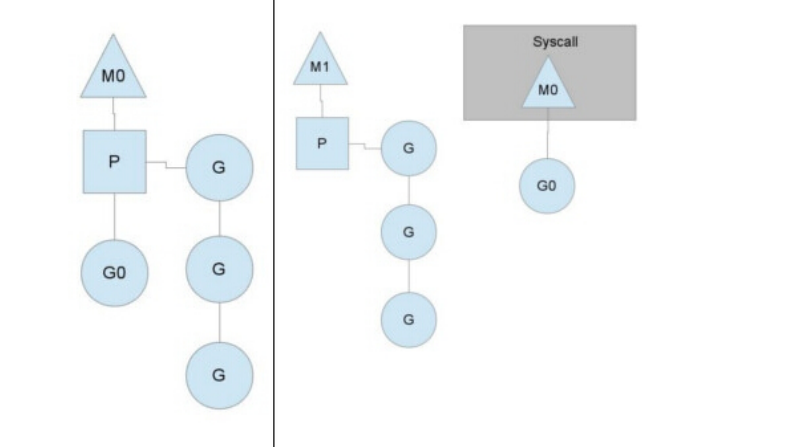
当M0返回时,它会尝试从其他线程中“偷”一个上下文过来,如果没有偷到,会把Goroutine放到Global runqueue 中去,然后把自己放入线程缓存中。上下文会定时检查Global runqueue。 Golang是为并发而生的语言,Go语言是为数不多的在语言层面实现并发的语言;也正是Go语言的并发特性,吸引了全球无数的开发者。 Golang的CSP并发模型,是通过Goroutine和Channel来实现的。 Goroutine 是Go语言中并发的执行单位。有点抽象,其实就是和传统概念上的”线程“类似,可以理解为”线程“。 Channel是Go语言中各个并发结构体(Goroutine)之前的通信机制。通常Channel,是各个Goroutine之间通信的” 管道“,有点类似于Linux中的管道。通信机制channel也很方便,传数据用channel <- data,取数据用<-channel。在通信过程中,传数据channel <- data和取数据<-channel必然会成对出现,因为这边传,那边取,两个goroutine之间才会实现通信。而且不管传还是取,必阻塞,直到另外的goroutine传或者取为止
Golang 中 Goroutine 如何调度
PDF 出处:第 25–27 页 · 原卷分组:进阶-并发编程 · 源标题
p025-h01。
goroutine是Golang语言中最经典的设计,也是其魅力所在,goroutine的本质是协程,是实现并行计算的核心。 goroutine使用方式非常的简单,只需使用go关键字即可启动一个协程,并且它是处于异步方式运行,你不需要等它运行完成以后在执行以后的代码。 go func()//通过go关键字启动一个协程来运行函数协程:协程拥有自己的寄存器上下文和栈。协程调度切换时,将寄存器上下文和栈保存到其他地方,在切回来的时候,恢复先前保存的寄存器上下文和栈。因此,协程能保留上一次调用时的状态(即所有局部状态的一个特定组合),每次过程重入时,就相当于进入上一次调用的状态,换种说法:进入上一次离开时所处逻辑流的位置。线程和进程的操作是由程序触发系统接口,最后的执行者是系统;协程的操作执行者则是用户自身程序,goroutine也是协程。 groutine能拥有强大的并发实现是通过GPM调度模型实现.
Go的调度器内部有四个重要的结构:M,P,S,Sched,如上图所示(Sched未给出).
M:M代表内核级线程,一个M就是一个线程,goroutine就是跑在M之上的;M是一个很大的结构,里面维护小对象内存cache(mcache)、当前执行的goroutine、随机数发生器等等非常多的信息
G:代表一个goroutine,它有自己的栈,instruction pointer和其他信息(正在等待的channel等等),用于调度。
P:P全称是Processor,处理器,它的主要用途就是用来执行goroutine的,所以它也维护了一个goroutine队列,里面存储了所有需要它来执行的goroutine
Sched:代表调度器,它维护有存储M和G的队列以及调度器的一些状态信息等
调度实现:
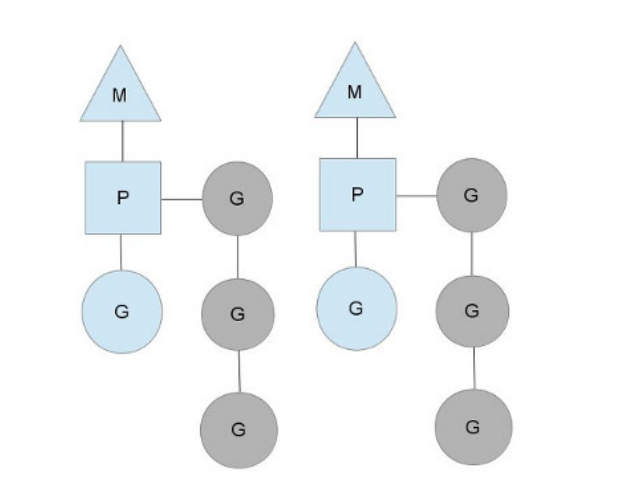
从上图中可以看到,有2个物理线程M,每一个M都拥有一个处理器P,每一个也都有一个正在运行的goroutine。P 的数量可以通过GOMAXPROCS()来设置,它其实也就代表了真正的并发度,即有多少个goroutine可以同时运行。图中灰色的那些goroutine并没有运行,而是出于ready的就绪态,正在等待被调度。P维护着这个队列(称之为 runqueue),Go语言里,启动一个goroutine很容易:go function就行,所以每有一个go语句被执行, runqueue队列就在其末尾加入一个goroutine,在下一个调度点,就从runqueue中取出(如何决定取哪个 goroutine?)一个goroutine执行。当一个OS线程M0陷入阻塞时,P转而在运行M1,图中的M1可能是正被创建,或者从线程缓存中取出
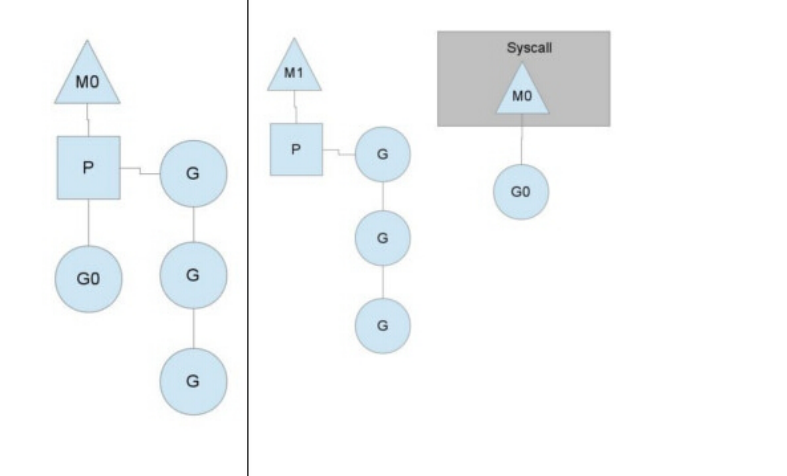
当MO返回时,它必须尝试取得一个P来运行goroutine,一般情况下,它会从其他的OS线程那里拿一个P过来,如果没有拿到的话,它就把goroutine放在一个global runqueue里,然后自己睡眠(放入线程缓存里)。所有的P也会周期性的检查global runqueue并运行其中的goroutine,否则global runqueue上的goroutine永远无法执行。另一种情况是P所分配的任务G很快就执行完了(分配不均),这就导致了这个处理器P很忙,但是其他的P还有任务,此时如果global runqueue没有任务G了,那么P不得不从其他的P里拿一些G来执行。
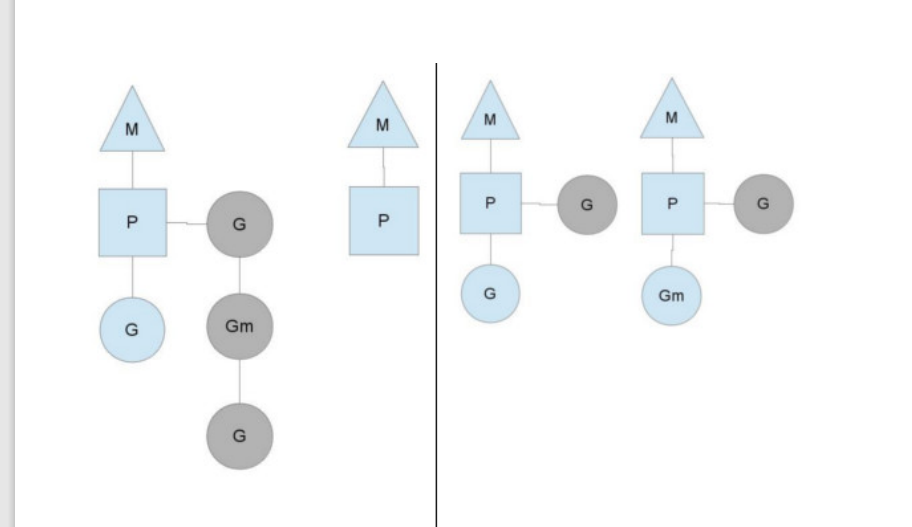
通常来说,如果P从其他的P那里要拿任务的话,一般就拿run queue的一半,这就确保了每个OS线程都能充分的使用。
Golang 中常用的并发模型
PDF 出处:第 27–30 页 · 原卷分组:进阶-并发编程 · 源标题
p027-h01。
Golang 中常用的并发模型有三种:
- 通过channel通知实现并发控制无缓冲的通道指的是通道的大小为0,也就是说,这种类型的通道在接收前没有能力保存任何值,它要求发送 goroutine 和接收 goroutine 同时准备好,才可以完成发送和接收操作。从上面无缓冲的通道定义来看,发送 goroutine 和接收 gouroutine 必须是同步的,同时准备后,如果没有同时准备好的话,先执行的操作就会阻塞等待,直到另一个相对应的操作准备好为止。这种无缓冲的通道我们也称之为同步通道
go
func main() {
	ch := make(chan struct{})
	go func() {
		fmt.Println("start working")
		time.Sleep(time.Second * 1)
		ch <- struct{}{}
	}()
	<-ch
	fmt.Println("finished")
}
当主 goroutine 运行到 <-ch 接受 channel 的值的时候,如果该 channel 中没有数据,就会一直阻塞等待,直到有值。这样就可以简单实现并发控制
- 通过sync包中的WaitGroup实现并发控制
Goroutine是异步执行的,有的时候为了防止在结束mian函数的时候结束掉Goroutine,所以需要同步等待,这个时候就需要用 WaitGroup了,在 sync 包中,提供了 WaitGroup,它会等待它收集的所有goroutine 任务全部完成。在WaitGroup里主要有三个方法:
Add, 可以添加或减少 goroutine的数量.
Done, 相当于Add(-1).
Wait, 执行后会堵塞主线程,直到WaitGroup 里的值减至0.
在主 goroutine 中 Add(delta int) 索要等待goroutine 的数量。在每一个 goroutine 完成后 Done() 表示这一个 goroutine 已经完成,当所有的 goroutine 都完成后,在主 goroutine 中 WaitGroup 返回
go
func main() {
	var wg sync.WaitGroup
	var urls = []string{
		"http://www.golang.org/",
		"http://www.google.com/",
	}
	for _, url := range urls {
		wg.Add(1)
		go func(url string) {
			defer wg.Done()
			http.Get(url)
		}(url)
	}
	wg.Wait()
}
在Golang官网中对于WaitGroup介绍是 A WaitGroup must not be copied after first use ,在WaitGroup 第一次使用后,不能被拷⻉应用示例:
go
func main() {
	wg := sync.WaitGroup{}
	for i := 0; i < 5; i++ {
		wg.Add(1)
		go func(wg sync.WaitGroup, i int) {
			fmt.Printf("i:%d", i)
			wg.Done()
		}(wg, i)
	}
	wg.Wait()
	fmt.Println("exit")
}
运行:
text
i:1i:3i:2i:0i:4fatal error: all goroutines are asleep - deadlock!
goroutine 1 [semacquire]:
sync.runtime_Semacquire(0xc000094018)
 /home/keke/soft/go/src/runtime/sema.go:56 +0x39
sync.(*WaitGroup).Wait(0xc000094010)
 /home/keke/soft/go/src/sync/waitgroup.go:130 +0x64
main.main()
 /home/keke/go/Test/wait.go:17 +0xab
exit status 2
它提示所有的 goroutine 都已经睡眠了,出现了死锁。这是因为 wg 给拷⻉传递到了 goroutine 中,导致只有 Add 操作,其实 Done操作是在 wg 的副本执行的。因此 Wait 就死锁了。这个第一个修改方式:将匿名函数中 wg 的传入类型改为 *sync.WaitGrou,这样就能引用到正确的WaitGroup了。这个第二个修改方式:将匿名函数中的 wg 的传入参数去掉,因为Go支持闭包类型,在匿名函数中可以直接使用外面的 wg 变量
- 在Go 1.7 以后引进的强大的Context上下文,实现并发控制
通常,在一些简单场景下使用 channel 和 WaitGroup 已经足够了,但是当面临一些复杂多变的网络并发场景下 channel 和 WaitGroup 显得有些力不从心了。比如一个网络请求 Request,每个 Request 都需要开启一个 goroutine 做一些事情,这些 goroutine 又可能会开启其他的 goroutine,比如数据库和RPC服务。所以我们需要一种可以跟踪 goroutine 的方案,才可以达到控制他们的目的,这就是Go语言为我们提供的 Context,称之为上下文非常贴切,它就是goroutine 的上下文。它是包括一个程序的运行环境、现场和快照等。每个程序要运行时,都需要知道当前程序的运行状态,通常Go 将这些封装在一个 Context 里,再将它传给要执行的 goroutine context 包主要是用来处理多个 goroutine 之间共享数据,及多个 goroutine 的管理。 context 包的核心是 struct Context,接口声明如下:
go
// A Context carries a deadline, cancelation signal, and request-scoped values
// across API boundaries. Its methods are safe for simultaneous use by multiple
// goroutines.
type Context interface {
	// Done returns a channel that is closed when this `Context` is canceled
	// or times out.
	Done() <-chan struct{}
	// Err indicates why this Context was canceled, after the Done channel
	// is closed.
	Err() error
	// Deadline returns the time when this Context will be canceled, if any.
	Deadline() (deadline time.Time, ok bool)
	// Value returns the value associated with key or nil if none.
	Value(key interface{}) interface{}
}
Done() 返回一个只能接受数据的channel类型,当该context关闭或者超时时间到了的时候,该channel就会有一个取消信号 Err() 在Done() 之后,返回context 取消的原因。 Deadline() 设置该context cancel的时间点 Value() 方法允许 Context 对象携带request作用域的数据,该数据必须是线程安全的。 Context 对象是线程安全的,你可以把一个 Context 对象传递给任意个数的 gorotuine,对它执行取消操作时,所有 goroutine 都会接收到取消信号。一个 Context 不能拥有 Cancel 方法,同时我们也只能Done channel 接收数据。其中的原因是一致的:接收取消信号的函数和发送信号的函数通常不是一个。典型的场景是:父操作为子操作操作启动 goroutine,子操作也就不能取消父操作
并发编程概念是什么?
PDF 出处:第 30–30 页 · 原卷分组:进阶-并发编程 · 源标题
p030-h01。
并行是指两个或者多个事件在同一时刻发生;并发是指两个或多个事件在同一时间间隔发生。并行是在不同实体上的多个事件,并发是在同一实体上的多个事件。在一台处理器上“同时”处理多个任务,在多台处理器上同时处理多个任务。如hadoop分布式集群并发偏重于多个任务交替执行,而多个任务之间有可能还是串行的。而并行是真正意义上的“同时执行”。并发编程是指在一台处理器上“同时”处理多个任务。并发是在同一实体上的多个事件。多个事件在同一时间间隔发生。并发编程的目标是充分的利用处理器的每一个核,以达到最高的处理性能。
Mutex 几种状态
PDF 出处:第 30–30 页 · 原卷分组:进阶-并发编程 · 源标题
p030-h02。
mutexLocked — 表示互斥锁的锁定状态;
mutexWoken — 表示从正常模式被从唤醒;
mutexStarving — 当前的互斥锁进入饥饿状态;
waitersCount — 当前互斥锁上等待的 Goroutine 个数;
Mutex 正常模式和饥饿模式
PDF 出处:第 30–30 页 · 原卷分组:进阶-并发编程 · 源标题
p030-h03。
正常模式(非公平锁)正常模式下,所有等待锁的 goroutine 按照 FIFO(先进先出)顺序等待。唤醒的 goroutine 不会直接拥有锁,而是会和新请求 goroutine 竞争锁。新请求的 goroutine 更容易抢占:因为它正在 CPU 上执行,所以刚刚唤醒的 goroutine 20 有很大可能在锁竞争中失败。在这种情况下,这个被唤醒的goroutine 会加入到等待队列的前面。饥饿模式(公平锁)为了解决了等待 goroutine 队列的长尾问题饥饿模式下,直接由 unlock 把锁交给等待队列中排在第一位的 goroutine (队头),同时,饥饿模式下,新进来的 goroutine 不会参与抢锁也不会进入自旋状态,会直接进入等待队列的尾部。这样很好的解决了老的 goroutine 一直抢不到锁的场景。饥饿模式的触发条件:当一个 goroutine 等待锁时间超过 1 毫秒时,或者当前队列只剩下一个 goroutine 的时候, Mutex 切换到饥饿模式。总结对于两种模式,正常模式下的性能是最好的,goroutine 可以连续多次获取锁,饥饿模式解决了取锁公平的问题,但是性能会下降,这其实是性能和公平的一个平衡模式。
Mutex 允许自旋的条件
PDF 出处:第 30–31 页 · 原卷分组:进阶-并发编程 · 源标题
p030-h04。
锁已被占用,并且锁不处于饥饿模式。
积累的自旋次数小于最大自旋次数(active_spin=4)。
CPU 核数大于 1。
有空闲的 P。
当前 Goroutine 所挂载的 P 下,本地待运行队列为空。
RWMutex 实现
PDF 出处:第 31–31 页 · 原卷分组:进阶-并发编程 · 源标题
p031-h01。
通过记录 readerCount 读锁的数量来进行控制,当有一个写锁的时候,会将读锁数量设置为负数 1<<30。目的是让新进入的读锁等待之前的写锁释放通知读锁。同样的当有写锁进行抢占时,也会等待之前的读锁都释放完毕,才会开始 21 进行后续的操作。而等写锁释放完之后,会将值重新加上 1<<30, 并通知刚才新进入的读锁(rw.readerSem),两者互相限制。
RWMutex 注意事项
PDF 出处:第 31–31 页 · 原卷分组:进阶-并发编程 · 源标题
p031-h02。
RWMutex 是单写多读锁,该锁可以加多个读锁或者一个写锁
读锁占用的情况下会阻止写,不会阻止读,多个 Goroutine 可以同时获取读锁
写锁会阻止其他 Goroutine(无论读和写)进来,整个锁由该 Goroutine 独占
适用于读多写少的场景
RWMutex 类型变量的零值是一个未锁定状态的互斥锁
RWMutex 在首次被使用之后就不能再被拷贝
RWMutex 的读锁或写锁在未锁定状态,解锁操作都会引发 panic
RWMutex 的一个写锁去锁定临界区的共享资源,如果临界区的共享资源已被(读锁或写锁)锁定,这个写锁操作的 goroutine 将被阻塞直到解锁
RWMutex 的读锁不要用于递归调用,比较容易产生死锁
RWMutex 的锁定状态与特定的 goroutine 没有关联。一个 goroutine 可以 RLock(Lock),另一个 goroutine 可以 RUnlock(Unlock)
写锁被解锁后,所有因操作锁定读锁而被阻塞的 goroutine 会被唤醒,并都可以成功锁定读锁
读锁被解锁后,在没有被其他读锁锁定的前提下,所有因操作锁定写锁而被阻塞的 Goroutine,其中等待时间最长的一个 Goroutine 会被唤醒
Cond 是什么
PDF 出处:第 31–31 页 · 原卷分组:进阶-并发编程 · 源标题
p031-h03。
Cond 实现了一种条件变量,可以使用在多个 Reader 等待共享资源 ready 的场景(如果只有一读一写,一个锁或者 channel 就搞定了) 22 每个 Cond 都会关联一个 Lock(*sync.Mutex or *sync.RWMutex),当修改条件或者调用 Wait 方法时,必须加锁,保护 condition。
Broadcast 和 Signal 区别
PDF 出处:第 31–31 页 · 原卷分组:进阶-并发编程 · 源标题
p031-h04。
func (c *Cond) Broadcast() Broadcast 会唤醒所有等待 c 的 goroutine。调用 Broadcast 的时候,可以加锁,也可以不加锁。 func (c *Cond) Signal() Signal 只唤醒 1 个等待 c 的 goroutine。调用 Signal 的时候,可以加锁,也可以不加锁。
Cond 中 Wait 使用
PDF 出处:第 32–32 页 · 原卷分组:进阶-并发编程 · 源标题
p032-h01。
func (c *Cond) Wait() Wait()会自动释放 c.L 锁,并挂起调用者的 goroutine。之后恢复执行, Wait()会在返回时对 c.L 加锁。除非被 Signal 或者 Broadcast 唤醒,否则 Wait()不会返回。由于 Wait()第一次恢复时,C.L 并没有加锁,所以当 Wait 返回时,调用者通常并不能假设条件为真。如下代码:。取而代之的是, 调用者应该在循环中调用 Wait。(简单来说,只要想使用 condition,就必须加锁。)
go
c.L.Lock()
for !condition() {
 c.Wait()
}
... make use of condition ...
c.L.Unlock()
WaitGroup 用法
PDF 出处:第 32–32 页 · 原卷分组:进阶-并发编程 · 源标题
p032-h02。
一个 WaitGroup 对象可以等待一组协程结束。使用方法是:
main 协程通过调用 wg.Add(delta int) 设置 worker 协程的个数,然后创建 worker 协程;
worker 协程执行结束以后,都要调用 wg.Done();
main 协程调用 wg.Wait() 且被 block,直到所有 worker 协程全部执行结束后返回。
WaitGroup 实现原理
PDF 出处:第 32–32 页 · 原卷分组:进阶-并发编程 · 源标题
p032-h03。
WaitGroup 主要维护了 2 个计数器,一个是请求计数器 v,一个是等待计数器 w,二者组成一个64bit 的值,请求计数器占高 32bit,等待计数器占低 32bit。
每次 Add 执行,请求计数器 v 加 1,Done 方法执行,等待计数器减 1,v 为 0 时通过信号量唤醒Wait()
什么是 sync.Once
PDF 出处:第 32–32 页 · 原卷分组:进阶-并发编程 · 源标题
p032-h04。
Once 可以用来执行且仅仅执行一次动作,常常用于单例对象的初始化场景。
Once 常常用来初始化单例资源,或者并发访问只需初始化一次的共享资源,或者在测试的时候初始化一次测试资源。
sync.Once 只暴露了一个方法 Do,你可以多次调用 Do 方法,但是只有第一次调用 Do 方法时 f 参数才会执行,这里的 f 是一个无参数无返回值的函数。
什么操作叫做原子操作
PDF 出处:第 32–32 页 · 原卷分组:进阶-并发编程 · 源标题
p032-h05。
原子操作即是进行过程中不能被中断的操作,针对某个值的原子操作在被进行的过程中,CPU 绝不会再去进行其他的针对该值的操作。为了实现这样的严谨性,原子操作仅会由一个独立的 CPU 指令代表和完成。原子操作是无锁的,常常直接通过 CPU 指令直接实现。事实上,其它同步技术的实现常常依赖于原子操作。
原子操作和锁的区别
PDF 出处:第 32–32 页 · 原卷分组:进阶-并发编程 · 源标题
p032-h06。
原子操作由底层硬件支持,而锁则由操作系统的调度器实现。锁应当用来保护一段逻辑,对于一个变量更新的保护。原子操作通常执行上会更有效率,并且更能利用计算机多核的优势,如果要更新的是一个复合对象,则应当使用 atomic.Value 封装好的实现
什么是 CAS
PDF 出处:第 33–33 页 · 原卷分组:进阶-并发编程 · 源标题
p033-h01。
CAS 的全称为 Compare And Swap,直译就是比较交换。是一条 CPU 的原子指令,其作用是让 CPU先进行比较两个值是否相等,然后原子地更新某个位置的值,其实现方式是给予硬件平台的汇编指令,在 intel 的 CPU 中,使用的 cmpxchg 指令,就是说 CAS 是靠硬件实现的,从而在硬件层面提升效率。简述过程是这样:假设包含 3 个参数内存位置(V)、预期原值(A)和新值(B)。V 表示要更新变量的值,E 表示预期值,N 表示新值。仅当 V 值等于 E 值时,才会将 V 的值设为 N,如果 V 值和 E 值不同,则说明已经有其他线程在做更新,则当前线程什么都不做,最后 CAS 返回当前 V 的真实值。CAS 操作时抱着乐观的态度进行的,它总是认为自己可以成功完成操作。基于这样的原理,CAS 操作即使没有锁,也可以发现其他线程对于当前线程的干扰。
sync.Pool 有什么用
PDF 出处:第 33–33 页 · 原卷分组:进阶-并发编程 · 源标题
p033-h02。
对于很多需要重复分配、回收内存的地方,sync.Pool 是一个很好的选择。频繁地分配、回收内存会给GC 带来一定的负担,严重的时候会引起 CPU 的毛刺。而 sync.Pool 可以将暂时将不用的对象缓存起来,待下次需要的时候直接使用,不用再次经过内存分配,复用对象的内存,减轻 GC 的压力,提升系统的性能。